看一遍就理解:MVCC 原理详解
介绍
MVCC(Multi-Version Concurrency Control,多版本并发控制)是一种用于实现数据库并发访问控制的机制。它允许多个用户同时读写同一数据项,从而提高了数据库在高并发环境下的性能和响应速度。以下是具体介绍:
- 基本概念:
- MVCC 通过为每行数据维护多个版本来工作,每个版本都有自己的创建时间和事务 ID。当一个事务需要读取数据时,它会读取对应版本的数据,而不是最新的数据。
- MVCC 避免了使用传统的锁机制来管理数据的并发访问,减少了锁竞争,从而提升了系统的吞吐量和响应时间。
- 工作机制:
- MVCC 中,每个事务开始时都会创建一个 ReadView,这是一个数据快照,记录了当前活跃的所有事务 ID。当事务进行查询操作时,它会利用这个快照来判断哪些数据是可见的。
- 对于 INSERT、UPDATE 或 DELETE 操作,系统会创建新的数据版本,并链接到旧版本上形成版本链。每个版本都保存了创建该版本的事务 ID 和时间戳。
- 关键组件:
- 系统中的每个事务都会被分配一个唯一的事务 ID。这些 ID 用于追踪数据的版本以及决定哪些版本对特定事务是可见的。
- 除了用户定义的数据列外,数据库还会为每个记录维护一些隐藏的元数据列,如行 ID、事务 ID 和回滚指针等。这些信息用于支持 MVCC 的内部运作。
- 隔离级别:
- 在读已提交(READ COMMITTED)和可重复读(REPEATABLE READ)隔离级别下,MVCC 通过生成数据的时间点快照来避免脏读、不可重复读和幻读现象的发生。不同的隔离级别决定了事务如何定义它们的 ReadView。
- 应用场景:
- MVCC 特别适用于具有高读 / 写比率的数据库环境,如联机事务处理系统(OLTP),可以显著提高系统的并发性能和数据一致性。
- 优缺点:
- 提高了并发处理能力,减少了等待锁释放的时间。
- 降低了死锁的风险,因为减少了锁的使用。
- 增加了系统的复杂性,可能会增加设计和调试的难度。
- 在某些情况下,可能需要额外的存储空间来保存多版本的数据。
总的来说,MVCC 是现代 关系型数据库 管理系统中一个至关重要的功能,它通过允许并行访问数据的方式来优化数据库的性能。理解其工作原理和实现方式有助于更好地设计和维护数据库应用,特别是在需要处理大量并发事务的环境中。
解决的 MySQL 问题背景
1.1 什么是数据库事务,为什么要有事务
事务,由一个有限的数据库操作序列构成,这些操作要么全部执行, 要么全部不执行,是一个不可分割的工作单位。
假如 A 转账给 B 100 元,先从 A 的账户里扣除 100 元,再在 B 的账户上加上 100 元。如果扣完 A 的 100 元后,还没来得及给 B 加上,银行系统异常了,最后导致 A 的余额减少了,B 的余额却没有增加。所以就需要事务,将 A 的钱回滚回去,就是这么简单。
为什么要有事务呢? 就是为了保证数据的最终一致性。
1.2 事务包括哪几个特性?
事务四个典型特性,即 ACID,原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)、持久性(Durability)。
- 原子性:事务作为一个整体被执行,包含在其中的对数据库的操作要么全部都执行,要么都不执行。
- 一致性:指在事务开始之前和事务结束以后,数据不会被破坏,假如 A 账户给 B 账户转 10 块钱,不管成功与否,A 和 B 的总金额是不变的。
- 隔离性:多个事务并发访问时,事务之间是相互隔离的,一个事务不应该被其他事务干扰,多个并发事务之间要相互隔离。。
- 持久性:表示事务完成提交后,该事务对数据库所作的操作更改,将持久地保存在数据库之中。
1.3 事务并发存在的问题
1.3.1 脏读
当一个事务正在访问数据并且对数据进行了修改,而这种修改还没有提交到数据库中,这时另外一个事务也访问了这个数据,因为这个数据是还没有提交的数据,那么另外一个事务读到的这个数据是 “脏数据”,依据“脏数据” 所做的操作可能是不正确的。
1.3.2 不可重复读
比如在一个事务内多次读同一数据。在这个事务还没有结束时,另一个事务也访问该数据。那么,在第一个事务中的两次读数据之间,由于第二个事务的修改导致第一个事务两次读取的数据可能不太一样。这就发生了在一个事务内两次读到的数据是不一样的情况,因此称为不可重复读。
1.3.3 幻读
幻读与不可重复读类似。它发生在一个事务(T1)读取了几行数据,接着另一个并发事务(T2)插入了一些数据时。在随后的查询中,第一个事务(T1)就会发现多了一些原本不存在的记录,就好像发生了幻觉一样,所以称为幻读,他和不可重复读的主要区别在于一个每次读取是数据不一样,一个是读取的数量不一样。
1.4 四大隔离级别
为了解决并发事务存在的脏读、不可重复读、幻读等问题,数据库大叔设计了四种隔离级别。分别是读未提交,读已提交,可重复读,串行化(Serializable)。
1.4.1 读未提交
读未提交隔离级别,只限制了两个数据不能同时修改,但是修改数据的时候,即使事务未提交,都是可以被别的事务读取到的,这级别的事务隔离有脏读、重复读、幻读的问题;
1.4.2 读已提交
读已提交隔离级别,当前事务只能读取到其他事务提交的数据,所以这种事务的隔离级别解决了脏读问题,但还是会存在重复读、幻读问题;
1.4 3 可重复读
可重复读隔离级别,限制了读取数据的时候,不可以进行修改,所以解决了重复读的问题,但是读取范围数据的时候,是可以插入数据,所以还会存在幻读问题;
1.4.4 串行化
事务最高的隔离级别,在该级别下,所有事务都是进行串行化顺序执行的。可以避免脏读、不可重复读与幻读所有并发问题。但是这种事务隔离级别下,事务执行很耗性能。
1.5 数据库是如何保证事务的隔离性的呢?
数据库是通过加锁,来实现事务的隔离性的。这就好像,如果你想一个人静静,不被别人打扰,你就可以在房门上加上一把锁。
加锁确实好使,可以保证隔离性。比如串行化隔离级别就是加锁实现的。但是频繁的加锁,导致读数据时,没办法修改,修改数据时,没办法读取,大大降低了数据库性能。
那么,如何解决加锁后的性能问题的?
答案就是,MVCC 多版本并发控制!它实现读取数据不用加锁,可以让读取数据同时修改。修改数据时同时可读取。
MVCC 实现原理
主要依赖于记录中的三个隐藏字段、undolog,read view 来实现的。
1、隐藏字段
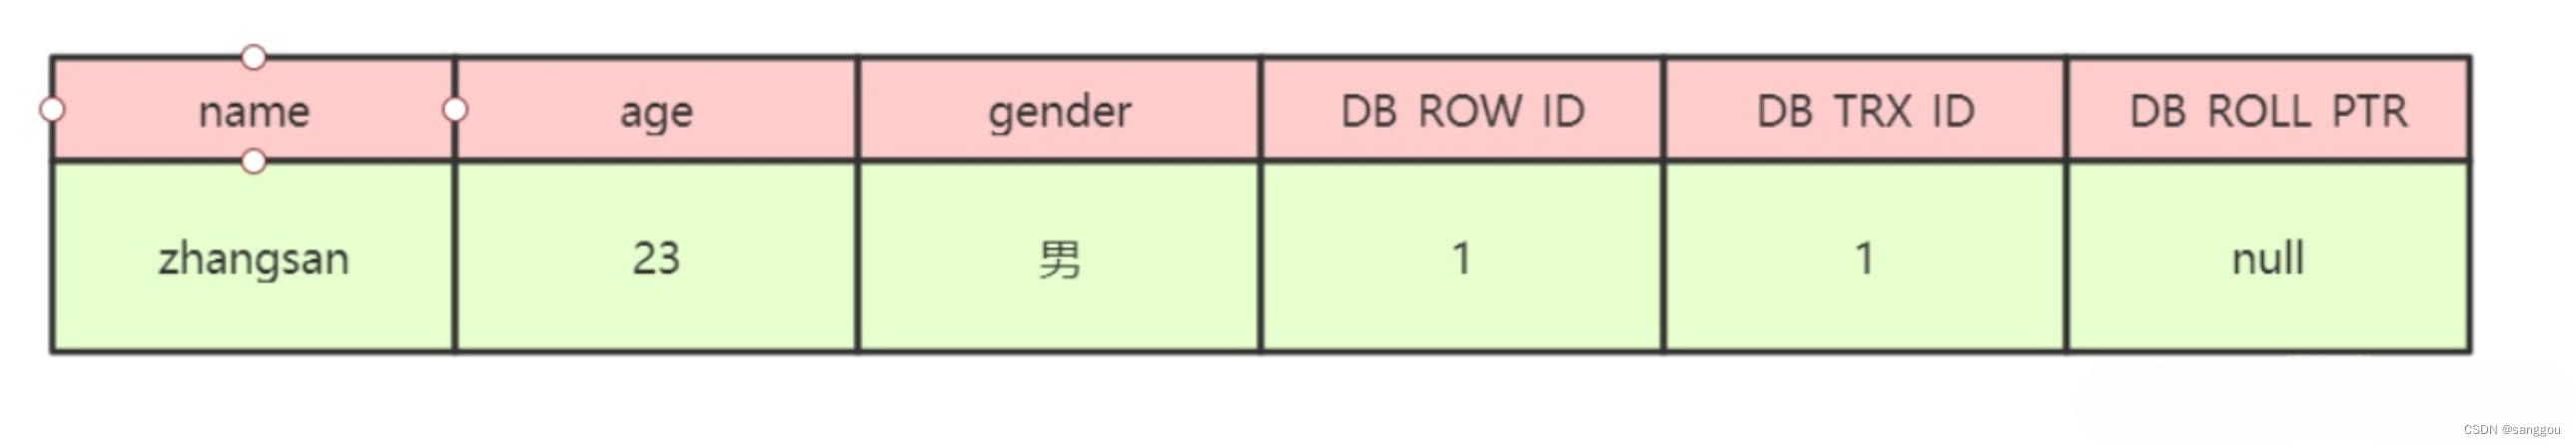
每行记录,除了我们自定义的字段外,还有数据库隐式定义的 DB_TRX_ID,DB_ROLL_PTR,DB_ROW_ID 等字段:
- DB_ROW_ID:6 字节,隐藏的主键,如果数据表没有主键,那么 innodb 会自动生成一个 6 字节的 row_id
- DB_TRX_ID:6 字节,最近修改事务 id,记录创建这条记录或者最后一次修改该记录的事务 id
- DB_ROLL_PTR:7 字节,回滚指针,用于配合 undo 日志,指向上一个旧版本
假设有一条数据如下:
2、undolog
2.1 概念
回滚日志,表示在进行 insert,delete,update 操作的时候产生的方便回滚的日志。
2.2 说明
当进行 insert 操作的时候,产生的 undolog,只在事务回滚的时候需要用到,并且在事务提交之后可以被立刻丢弃
当进行 update 和 delete 操作的时候,产生的 undolog,不仅仅在事务回滚的时候需要,在快照读的时候也需要,所以不能随便删除,只有在快照读或事务回滚不涉及该日志时,对应的日志才会被 purge 线程统一清除
当数据发生更新和删除操作的时候,实际只是设置了旧记录的 deleted_bit,并不是将过时的记录删除,因为为了节省磁盘空间,innodb 有专门的 purge 线程来清除 deleted_bit 为 true 的记录,如果某个记录的 deleted_id 为 true,并且 DB_TRX_ID 相对于 purge 线程的 read view 可见,那么这条记录就是可以被清除的。
2.3 undolog 生成的记录链表
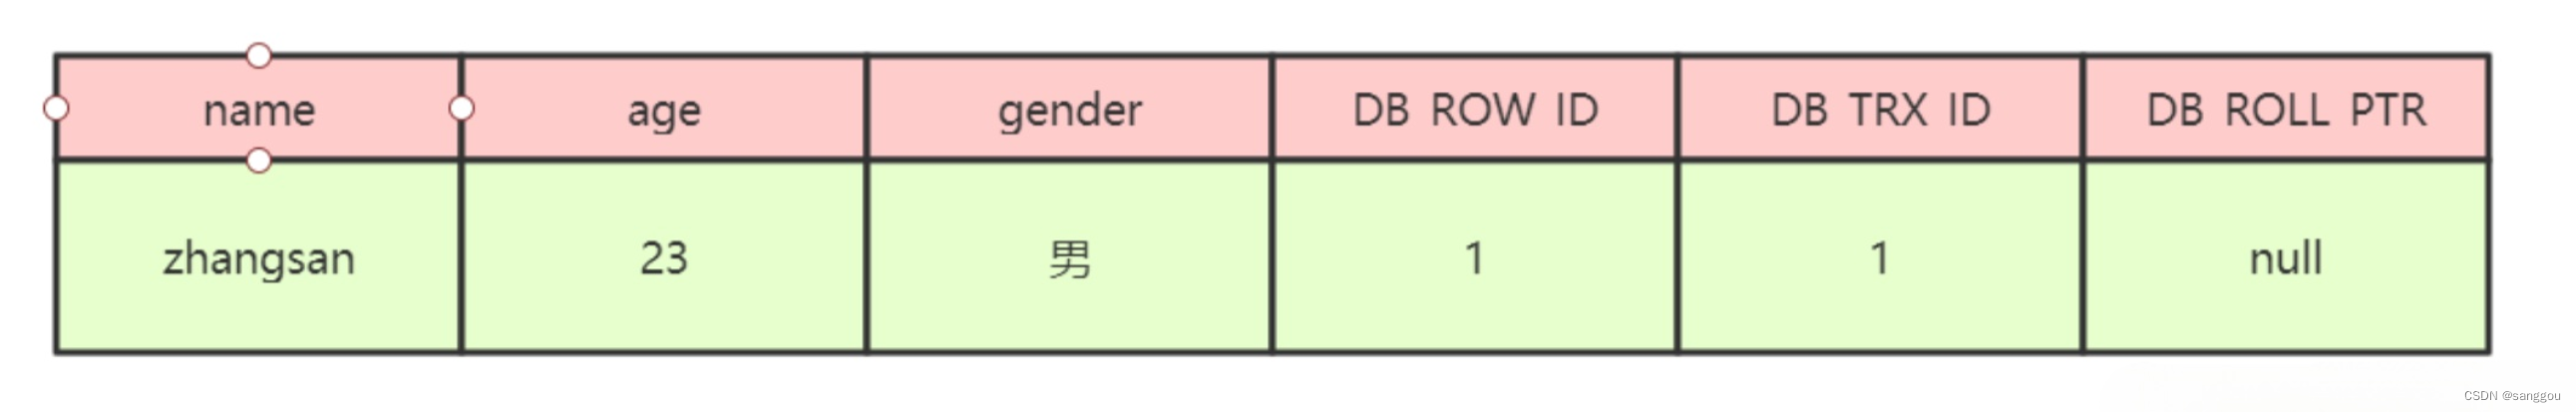
(1)假设有一个事务编号为 1 的事务向表中插入一条记录,那么此时行数据如下,主键 id=1,事务 id=1
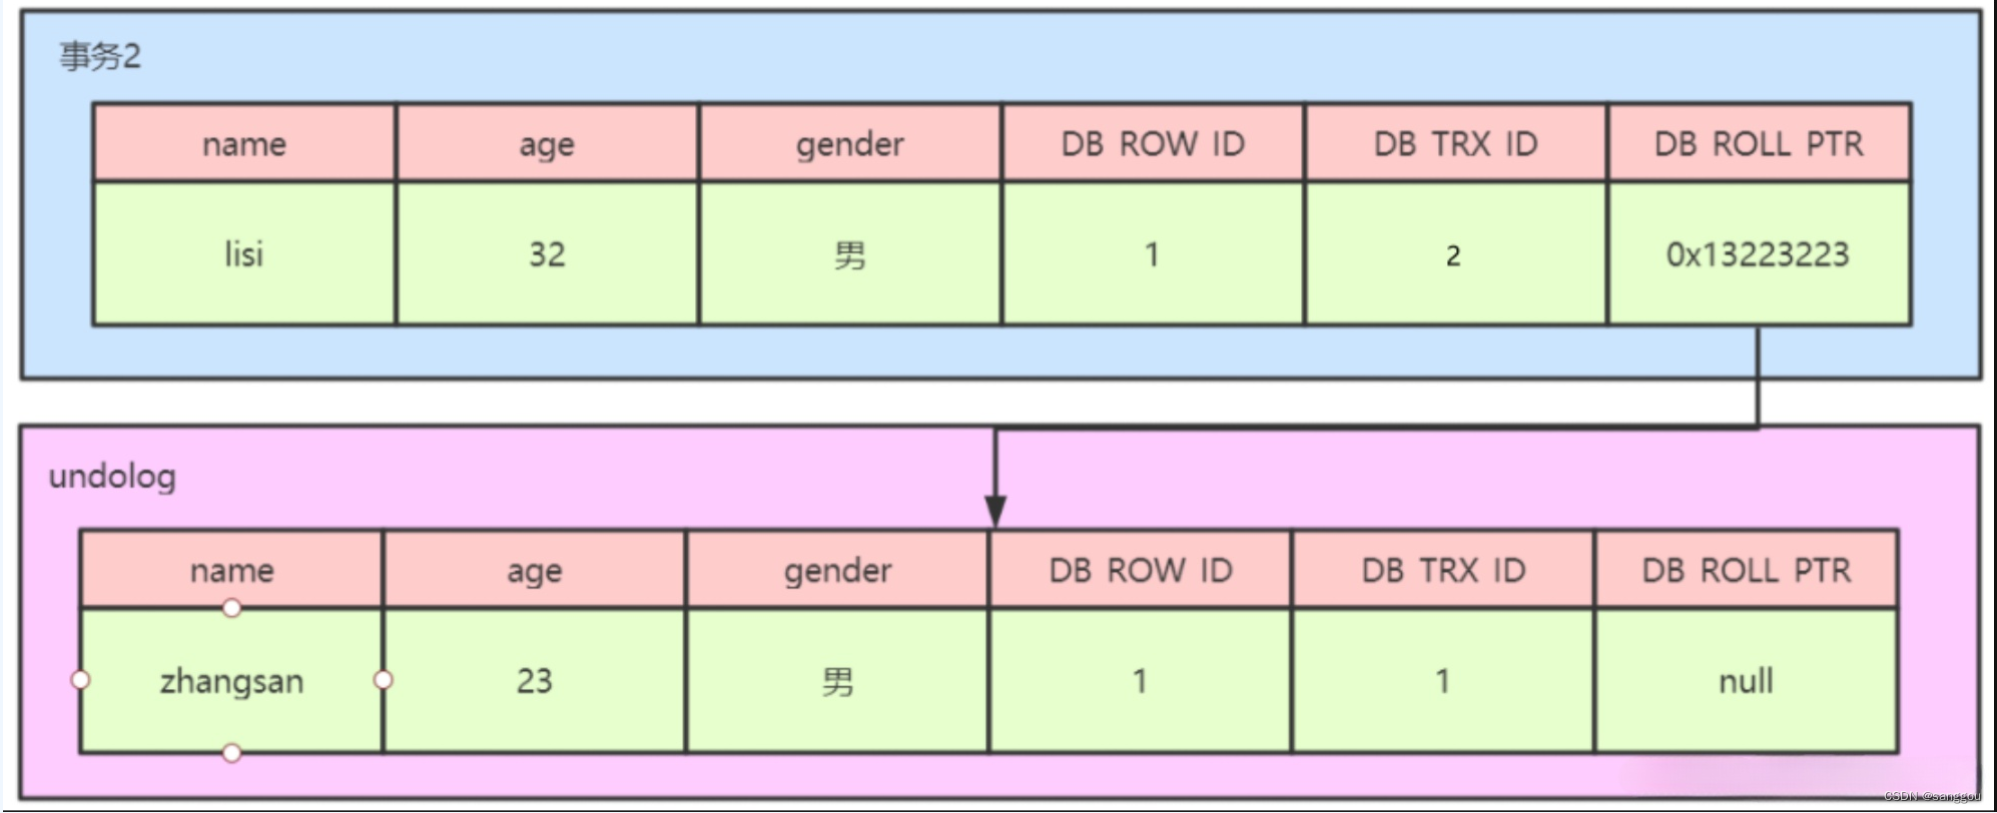
(2)假设有第二个事务(编号为 2)对该记录的 name 做出修改,改为 lisi
底层操作:在事务 2 修改该行记录数据时
1、对该数据行加排他锁
2、把该行数据拷贝到 undolog 中,作为旧记录
3、修改该行 name 为 lisi,并且修改事务 id=2,回滚指针指向拷贝到 undolog 的副本记录中
4、提交事务,释放锁
(3)假设有第三个事务(编号为 3)对该记录的 age 做了修改,改为 32
底层操作:在事务 3 修改该行记录数据时
1、对该数据行加排他锁
2、把该行数据拷贝到 undolog 中,作为旧记录,发现该行记录已经有 undolog 了,那么最新的旧数据作为链表的表头,插在该行记录的 undolog 最前面
3、修改该行 age 为 32 岁,并且修改事务 id=3,回滚指针指向刚刚拷贝的 undolog 的副本记录
4、提交事务,释放锁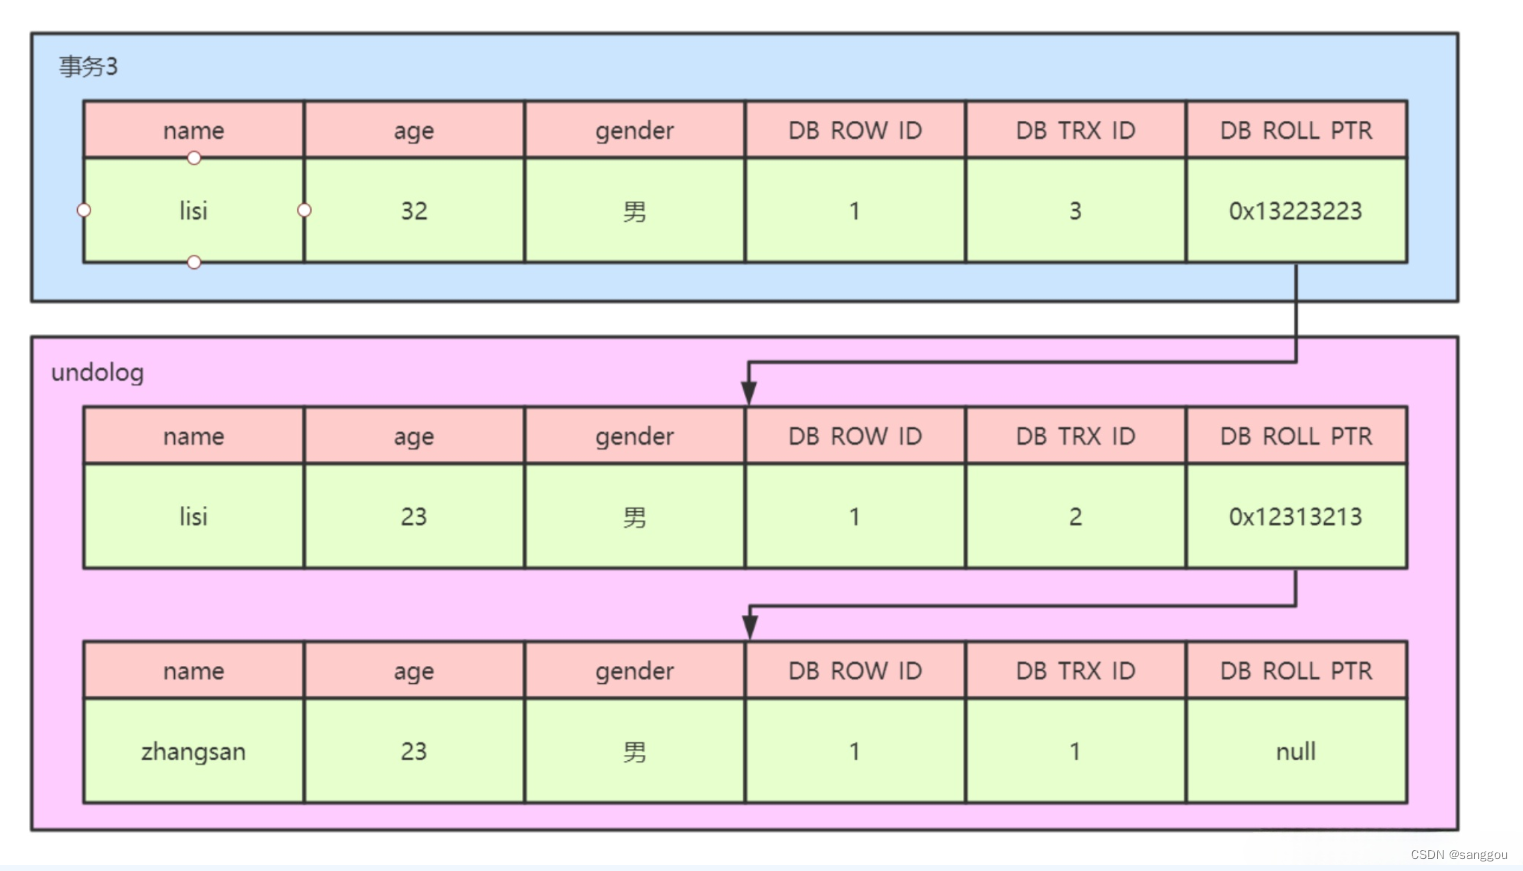
上述的一系列图中,可以发现,不同事务或者相同事务的对同一记录的修改,会导致该记录的 undolog 生成一条记录版本链表,undolog 的表头就是最新的旧记录,表尾就是最早的旧记录。
3、read view
Read View 是事务进行快照读操作的时候生产的读视图,在该事务执行快照读的那一刻,系统会生成一个此刻的快照,记录并维护系统此刻活跃事务的 id,用来做可见性判断的,也就是说当某个事务在执行快照读的时候,对该记录创建一个 Read View 的视图,把它当作条件去判断当前事务能够看到哪个版本的数据,有可能读取到的是最新的数据,也有可能读取到的是当前行记录的 undolog 中某个版本的数据
1)可见性 算法
将要被修改的数据的最新记录中的 DB_TRX_ID(当前事务 id)取出来,与系统此刻其他活跃事务的 id 去对比,如果 DB_TRX_ID 跟 Read View 的属性做了比较,不符合可见性,那么就通过 DB_ROLL_PTR 回滚指针去取出 undolog 中的 DB_TRX_ID 做比较,即遍历链表中的 DB_TRX_ID,直到找到满足条件的 DB_TRX_ID,这个 DB_TRX_ID 所在的旧记录就是当前事务能看到的数据。
2)可见性规则
首先要知道 Read View 中的三个全局属性:
- trx_list: 一个数值列表,用来维护 Read View 生成时刻系统正活跃的事务 ID(1,2,3)
- up_limit_id: 记录 trx_list 列表中事务 ID 最小的 ID(1)
- low_limit_id:Read View 生成时,系统即将分配的下一个事务 ID(4)
具体的比较规则如下:
- 首先比较 DB_TRX_ID < up_limit_id
如果小于,则当前事务能看到 DB_TRX_ID 所在的记录
如果大于等于,则进入下一个判断 - 接下来判断 DB_TRX_ID >= low_limit_id
如果大于等于,则代表 DB_TRX_ID 所在的记录在 Read View 生成后才出现的,那么对于当前事务不可见
如果小于,则进入下一步判断 - 判断 DB_TRX_ID 是否在活跃事务中,trx_list 包含 DB_TRX_ID
如果包含,则代表在 Read View 生成的时候,这个事务还是活跃状态,未 commit 的数据,当前事务也是看不到,如果不包含,则说明这个事务在 Read View 生成之前就已经开始 commit,那么修改的结果是能够看见的。
流程图 如下:
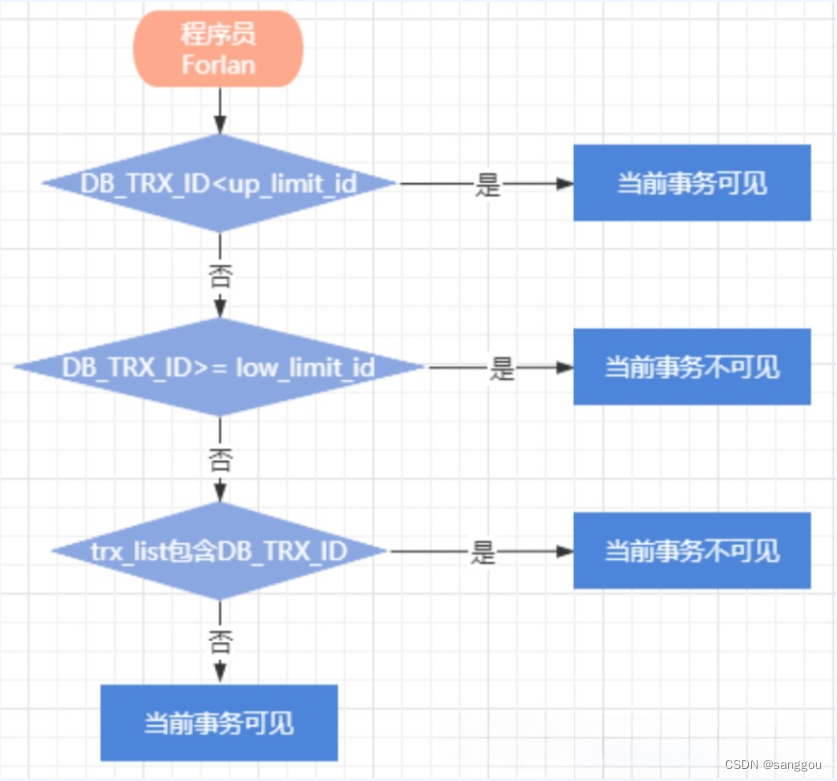
总结:两种情况可见
- DB_TRX_ID < up_limit_id
- DB_TRX_ID 不在 trx_list 范围内,且小于 low_limit_id
拓展 :在 RC 隔离级别下,是每个快照读都会生成并获取最新的 Read View,而在 RR 隔离级别下,则是同一个事务中的第一个快照读才会创建 Read View,之后的快照读获取的都是同一个 Read View。